SiliconANGLE AI ↗ · 2026-11-20 03:21 · UTC+8
 D-Matrix 押注堆叠 DRAM 以解决推理的内存带宽问题
媒体报道 SiliconANGLE AI 原文语言:英文
随着人工智能工作负载向推理转变,内存带宽决定了硬件生成 token 的速度。D-Matrix 公司推出了第二代芯片 Raptor,该芯片在其计算逻辑下方堆叠了 3D DRAM。这一设计带来了比 HBM 更高的能效和带宽,并支持异构计算。
全文
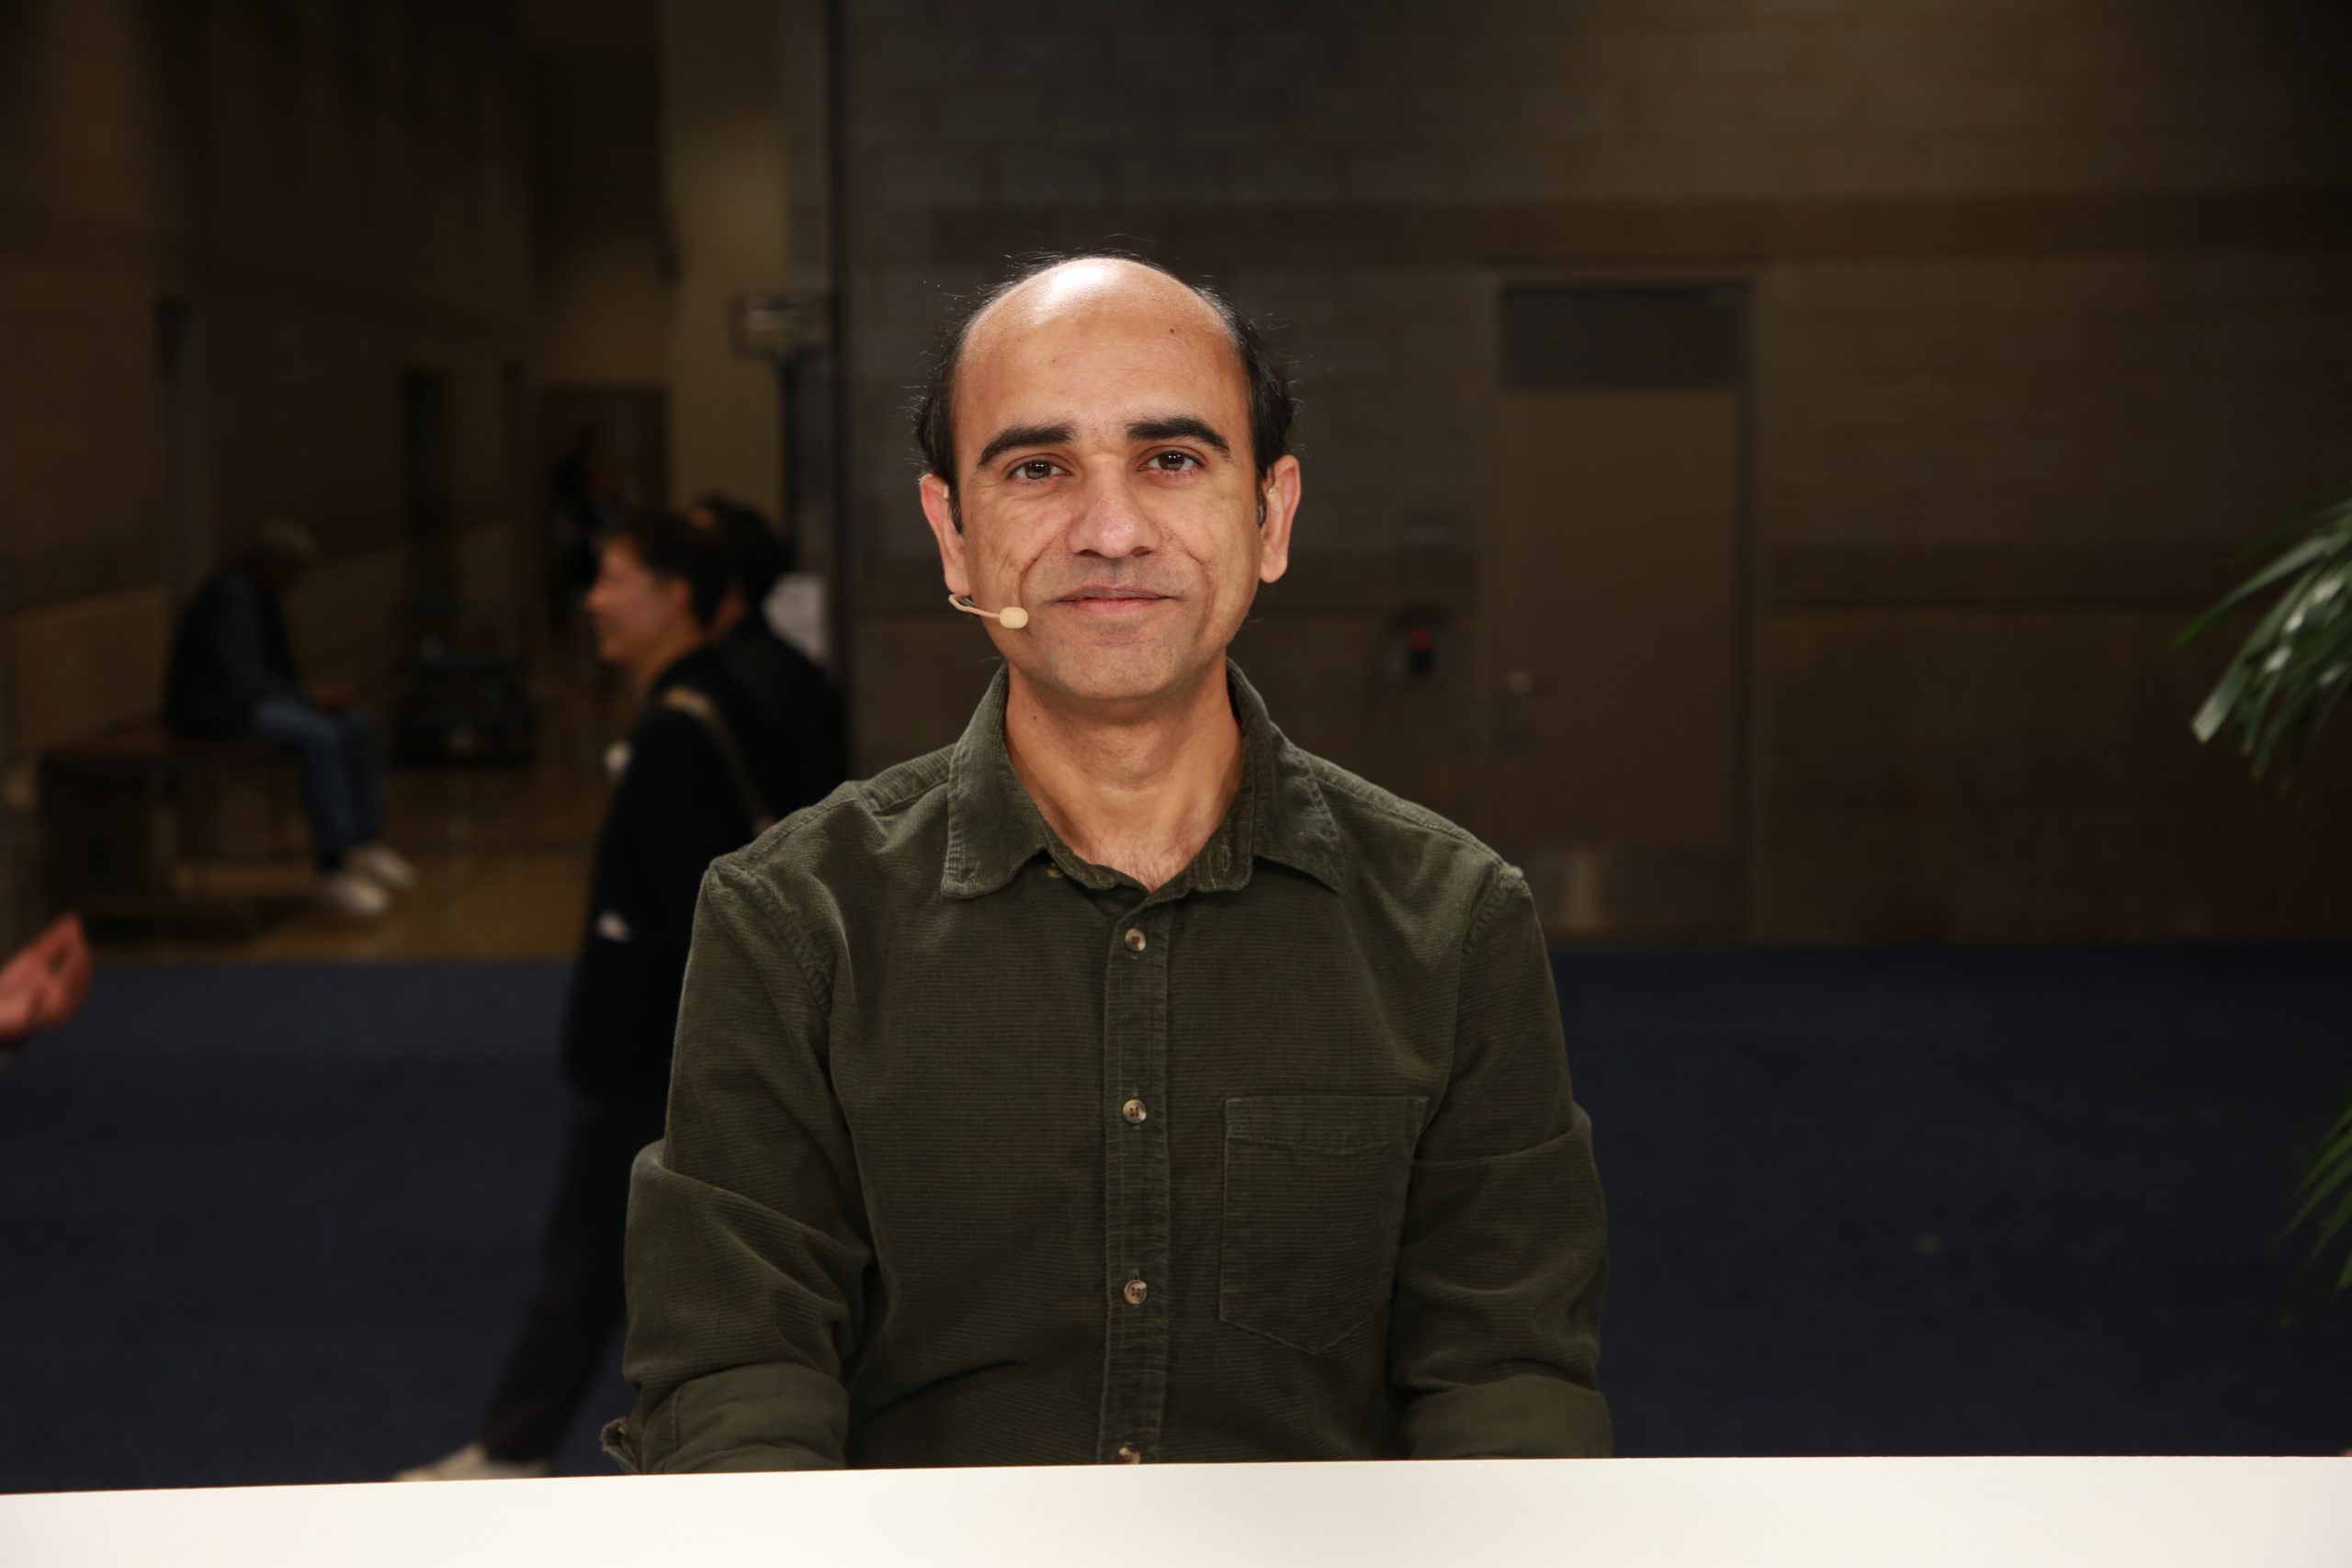
随着人工智能工作负载向推理转变,内存带宽决定了硬件是能快速生成 Token 还是处于闲置状态。d-Matrix 公司给出的解决方案是推出 Raptor,这是一款在其计算逻辑下方堆叠 3D DRAM 的第二代芯片。
d-Matrix 的资深研究员 Satyam Srivastava(如图)表示,AI 基础设施已经变成了一场系统级游戏,赢家会将内存、互连和软件融合成紧密结合的设计。
Srivastava 表示:“这不再只是一个芯片问题。芯片只是其中的一部分。内存带宽是一个必须解决的根本优势。接下来是能源效率,然后是互连效率,再然后是软件的内聚性。”
Srivastava 在 SC26 会议期间接受了 theCUBE Research 的 John Furrier 的采访,这是 SiliconANGLE Media 旗下直播工作室 theCUBE 的独家节目。他们讨论了 d-Matrix 的 Raptor 芯片及其堆叠的 3D DRAM、推理内存带宽以及向异构计算的转变。(* 披露信息见下文。)
Raptor 为推理引入了堆叠内存层
Srivastava 解释说,d-Matrix 会先通过测试芯片验证每一项具有风险的技术。Jayhawk 验证了芯片到芯片的连接,Jayhawk II 验证了数字存内计算。Corsair 加速器结合了这两项技术,并在今年早些时候投入全面生产。
Srivastava 表示:“快进到 Pavehawk 芯片(测试芯片),它正在验证堆叠在逻辑裸片下方的 3D DRAM,这将作为我们明年推出的第二代芯片 Raptor 的核心技术。”
这种堆叠方式保持了分布式内存架构的完整性,但将内存单元移到了单独的层上,而不是占用逻辑裸片的面积。数据传输距离极短,且无需穿过中介层。Srivastava 指出,这使得 3D DRAM 处于介于 SRAM 和高带宽内存 (HBM) 之间的新层级。
Srivastava 表示:“因此,与 HBM 相比,你的能效提升了 10 倍,带宽提升了 10 倍,而在容量方面,它恰好介于 SRAM 和 HBM 之间。”
Srivastava 指出,将基于 Corsair 的服务器与现有的 Hopper GPU 集群配对,可以将利用率从约 20% 提高到高达 80%,这意味着每花费一美元能获得更多的 Token。d-Matrix 还采用了来自 Nvidia 公司的 NVLink Fusion 机架级基础设施,将其加速器连接到 Nvidia 的 AI 工厂。
Srivastava 表示:“对我们而言,这开启了参与一个非常成熟的生态系统——世界上最受欢迎的 AI 工厂的机会。我们能够获得经过高度验证的 MGX 机架设计。”
Srivastava 解释说,这种合作伙伴关系指向了异构计算,其中软件将 GPU、CPU 和诸如 Raptor 等加速器协调为一个统一的系统,以整个集群作为计算单元。
Srivastava 表示:“因此,你可以把一个芯片想象成整个集群,它拥有许多不同的硬件单元。有些是 GPU,有些是 CPU,有些是 ASIC 加速器,你可以根据需要选择最适合工作负载需求的硬件。”
以下是完整的视频采访,这是 SiliconANGLE 和 theCUBE 对 SC26 报道的一部分:
(* 披露:NYSE Wired 赞助了 theCUBE 的这个访谈环节。NYSE Wired 或其他赞助商对 theCUBE 或 SiliconANGLE 上的内容均无编辑控制权。)
照片:SiliconANGLE
正文为 AI 译文。
参考来源




