SiliconANGLE AI ↗ · 2026-11-20 02:39 · UTC+8
Hitachi Vantara 押注更智能的存储以弥合 AI 从试点到生产的鸿沟
媒体报道 SiliconANGLE AI 原文语言:英文
Hitachi Vantara 在 SC26 上表示,AI 从试点走向生产的主要障碍是数据而非 GPU,存储正变成能原生分类、治理并提供数据的主动层。其 VSP One 平台新增对象存储与数据湖能力,可标记含个人信息的文件;CT 扫描元数据可以 Apache Iceberg 格式存储并直接查询,无需 ETL。
全文
将人工智能从试点推向生产的企业正在认识到,数据(而非 GPU)才是最难的部分,而 Apache Iceberg 等开放表格式正是解决方案的一部分。对 AI 基础设施的需求几乎没有放缓的迹象,但公司所需的大部分信息仍然分散、缺乏治理且难以触及。
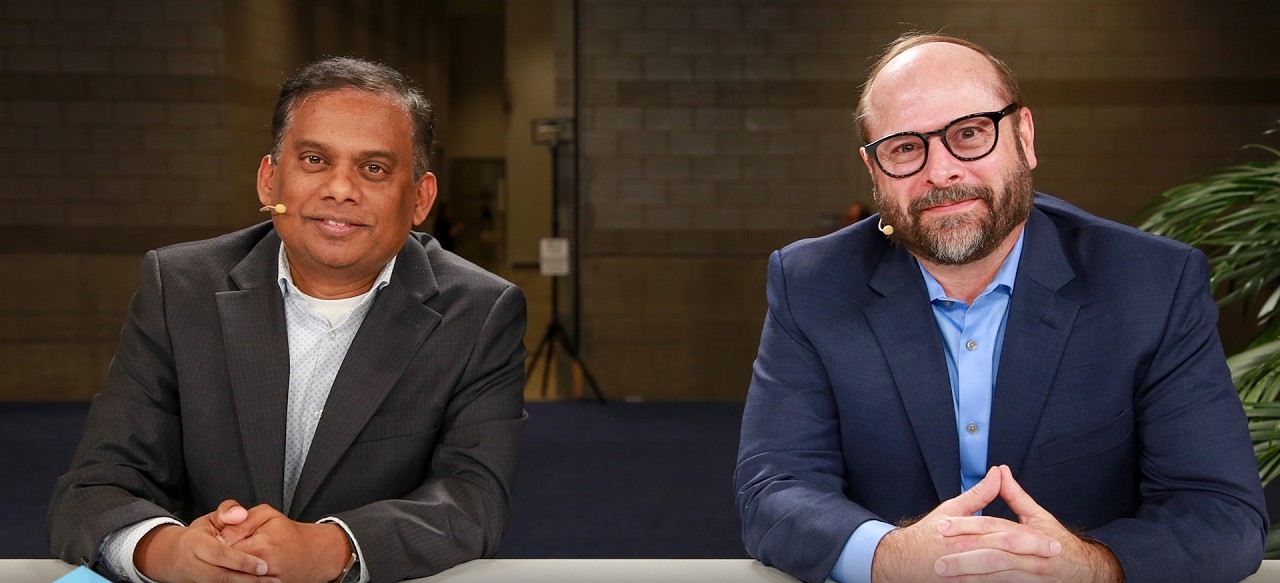
日立 Vantara 公司混合云与 AI 基础设施副总裁阿伦·普拉萨德·拉曼(Arun Prasad Raman,图左)表示,这种压力正在将存储转变为一个能够为模型分类、治理和提供数据的活跃层。诸如日志和医学影像等非结构化文件蕴含着 AI 现已能够提取的智能。
拉曼说:“存储不再仅仅被视为存储数据。你需要原生引入更多智能,而不是将数据移动到另一个副本并在稍后将其带回(例如用于索引)。如果它能够原生完成,这正是增值所在。”
拉曼与日立 Vantara 首席产品与解决方案经理杰夫·伦德伯格(Jeff Lundberg,图右)在 SC26 会议期间接受了 theCUBE Research 的约翰·弗里尔(John Furrier)和杰玛·艾伦(Gemma Allen)的采访,这是 SiliconANGLE Media 旗下直播室 theCUBE 的独家直播。他们讨论了 AI 的“从试点到生产”的鸿沟、Apache Iceberg 以及日立 Vantara 如何为存储增加智能。(* 以下为披露声明。)
Apache Iceberg 与对智能存储的推动
人工智能工厂和数据平台的参考架构基本已经确定。伦德伯格表示,大多数项目之所以停滞不前,是因为数据分散在本地系统、软件即服务(SaaS)应用程序和云端,而访问控制、治理和不断变化法规则增加了阻力。他解释说,日立 Vantara 正在通过构建在其 Hitachi iQ 栈以及其姊妹公司的铁路和能源经验之上的行业特定解决方案来应对这一挑战。
伦德伯格说:“这更多关乎结果,而不是我们试图采用的技术。技术只是实现你所追求的解决方案的赋能工具。”
现在,大部分此类工作都在存储中进行。上周,日立 Vantara 扩展了其 VSP One 平台,增加了新的对象存储和数据湖屋功能。拉曼解释说,其对象存储中的一项服务可以标记包含个人信息(例如社会安全号码)的文件。然后,数据科学家可以使这些数据远离特定模型,或者阻止其复制到另一个国家。
拉曼说:“这就是我们正在向存储本身添加的智能。这就是存储的演进使其变得更加智能的地方。”
分析遵循相同的逻辑。拉曼指出,CT 扫描元数据可以以 Apache Iceberg 格式存储在公司的对象存储中并进行直接查询。应用程序可以列出过去一年中的所有腹部扫描,而无需单独的提取、转换和加载(ETL)过程或数据库。
拉曼说:“无论是备份还是已有 10 年历史的数据,它依然承载着某种智能。只要它承载智能,它对 AI 而言就变得重要。”
以下是完整的视频采访,这是 SiliconANGLE 和 theCUBE 对 SC26 报道的一部分:
(* 披露:日立 Vantara Corp. 赞助了 theCUBE 的这一环节。日立 Vantara Corp. 或其他赞助商对 theCUBE 或 SiliconANGLE 上的内容没有编辑控制权。)
照片:SiliconANGLE
正文为 AI 译文。
参考来源




