OpenAI ↗ · 2026-11-20 08:00 · UTC+8
 人工智能能否帮助科学家识别有潜力的候选药物?
媒体报道 OpenAI 原文语言:英文
OpenAI 推出了 MedChemBench 这一新基准,用于评估 AI 模型阅读分子结构、解释实验结果及选择下一代测试化合物的推理任务能力。在 xhigh 推理设置下,GPT-6.2 Astra 获得了 84.5% 的可用分值。
全文
OpenAI
2026年11月20日
ResearchReleaseScience
AI能否帮助科学家识别有潜力的候选药物?
我们推出了 MedChemBench,这是一个基准测试,用于评估 AI 模型在阅读分子结构、解释实验结果以及选择下一步测试哪些化合物方面的表现。
阅读论文(在新窗口中打开)
00:00
我们推出了 MedChemBench,这是一个评估 AI 模型在药物化学研究推理任务中表现的基准测试。它测试模型是否能够将分子的结构与实验证据联系起来,以解释结果、比较化合物并预测其属性。构建能够可靠支持这项工作的 AI,是帮助科学家开发更好药物迈出的第一步。
这项工作最难的部分之一在于,改进分子的某一项属性可能会使另一项属性变差。一种化合物可能对与疾病相关的蛋白质具有很强的抑制作用,但吸收不良或在体内分解过快。药物化学家通过设计、制造和测试相关化合物来权衡这些取舍,然后决定接下来尝试什么。为了让 AI 发挥作用,它需要将分子结构的变化与实验证据联系起来,并对哪些化合物值得进一步研究进行推理。
MedChemBench 通过从已发表研究中提取的 99 个问题来衡量这些能力。在 xhigh 推理设置下,GPT‑6.2 Astra 获得了 84.5% 的可用分数,相比之下,GPT‑6 Astra 为 83.3%,GPT‑6.1 Sol 为 82.0%,GPT‑5.6 Sol 为 58.2%。GPT‑6 Astra 在重建分子结构和解释实验证据方面表现最强。选择化合物和预测其数值属性对该模型来说则更具挑战性。
MedChemBench 评分的内容
MedChemBench 借鉴了 117 篇论文和专利,包含 761 种不同的分子结构。对于大多数问题,模型会获得在研究项目选定时间点可用的上下文:生物靶标、研究人员的目标、迄今为止研究过的化合物以及选定的实验结果。
该基准测试评估四个组成部分:
分子结构。根据提供的绘图和化学基团组合出的分子,其原子连接正确且立体化学结构指定无误。
科学推理。有提供的证据支持的解释,例如选择某种化合物而非另一种化合物的原因。
排序与选择。符合既定要求的化合物排序与选择。
属性预测。与原始资料中报告的数值和类别相符,包括测得和计算出的分子属性。
对竞争属性的预测
MedChemBench 的一个问题借鉴了对 PRMT5 抑制剂的研究,PRMT5 是癌症药物发现中研究的一种蛋白质。模型接收了早期实验的分子结构和结果。它必须预测三种相关化合物的行为:它们在细胞中阻断 PRMT5 的强度、它们穿透细胞屏障的难易程度,以及在实验室测定中肝脏酶将其分解的速度。
未向模型公开的后期实验显示了一种权衡。化合物 23 在较低浓度下就能阻断细胞中的 PRMT5,而化合物 24 则更容易穿透细胞屏障并在肝酶测定中分解得更慢。
同时预测这些属性测试了模型是否能够将分子结构与化合物行为的多个方面联系起来。这反映了药物化学中的一个核心挑战:针对靶标的更强活性并不一定伴随着更好的渗透性或更慢的分解。
该基准测试检查模型是否正确重建了分子结构,以及其预测结果与实验测量值的吻合程度。预测结果会根据其与测量值的接近程度获得部分分数。提示中已经提供的数据也必须被正确重现。
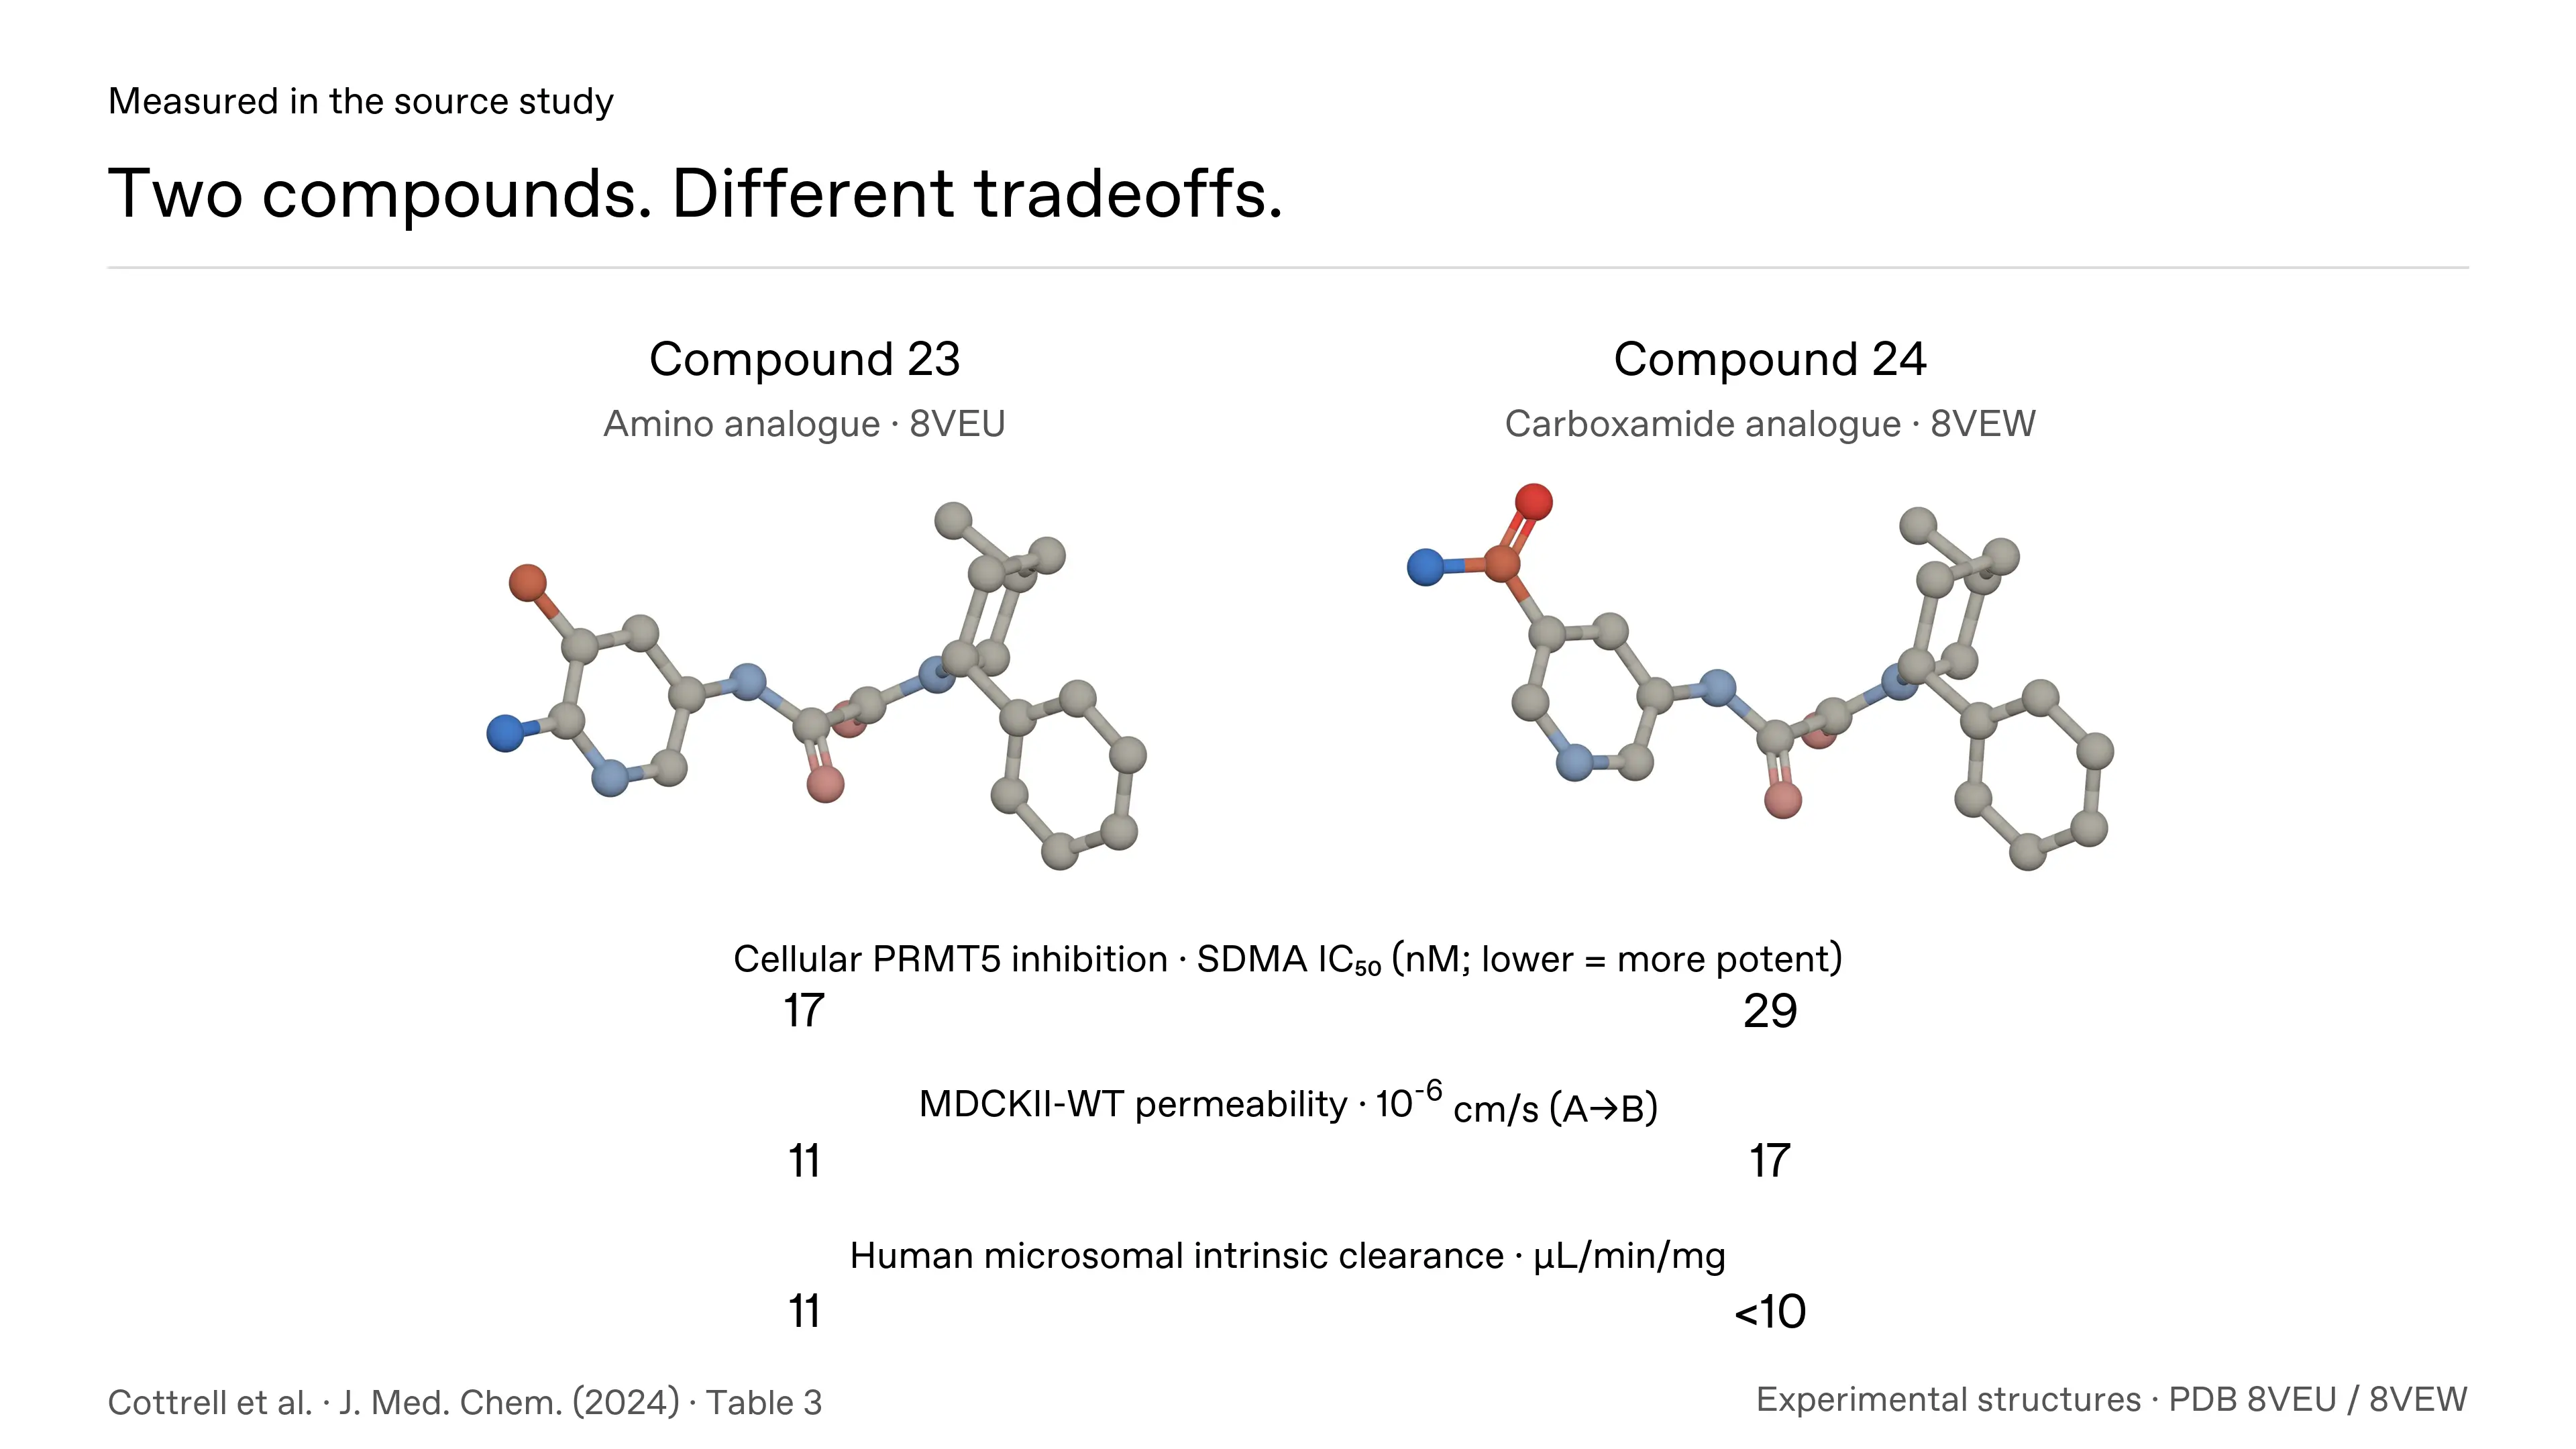
00:00
微小的化学变化会产生不同的属性曲线。该任务要求模型将结构与其行为的证据联系起来。
测试药物化学中的空间推理
在模型能够推理化合物的属性之前,它需要正确识别分子。化学图纸编码了原子连接、环结构和立体化学。
MedChemBench 测试模型在从提供的图纸和化学基团重建分子时是否保留了这些信息。
其中一个问题要求模型从一个中心结构和两个连接基团组装一个分子,同时保持一个18原子环。在所有十一个模型共享的最高推理设置(xhigh)下,GPT‑6 Astra在全部十次响应中都正确重建了该化合物。GPT‑5.6 Sol和GPT‑5.6 Luna在全部十次响应中均告失败。
在图示的答案中,GPT‑5.6 Sol生成了一个15原子环,而GPT‑5.6 Luna则将该分子分裂成两个不连通的碎片。
这些错误改变了被分析分子的身份。这个例子测试了药物化学推理的基础:模型是否能够在解释其行为之前准确表示该化合物。
图1。相同的输入,不同的分子
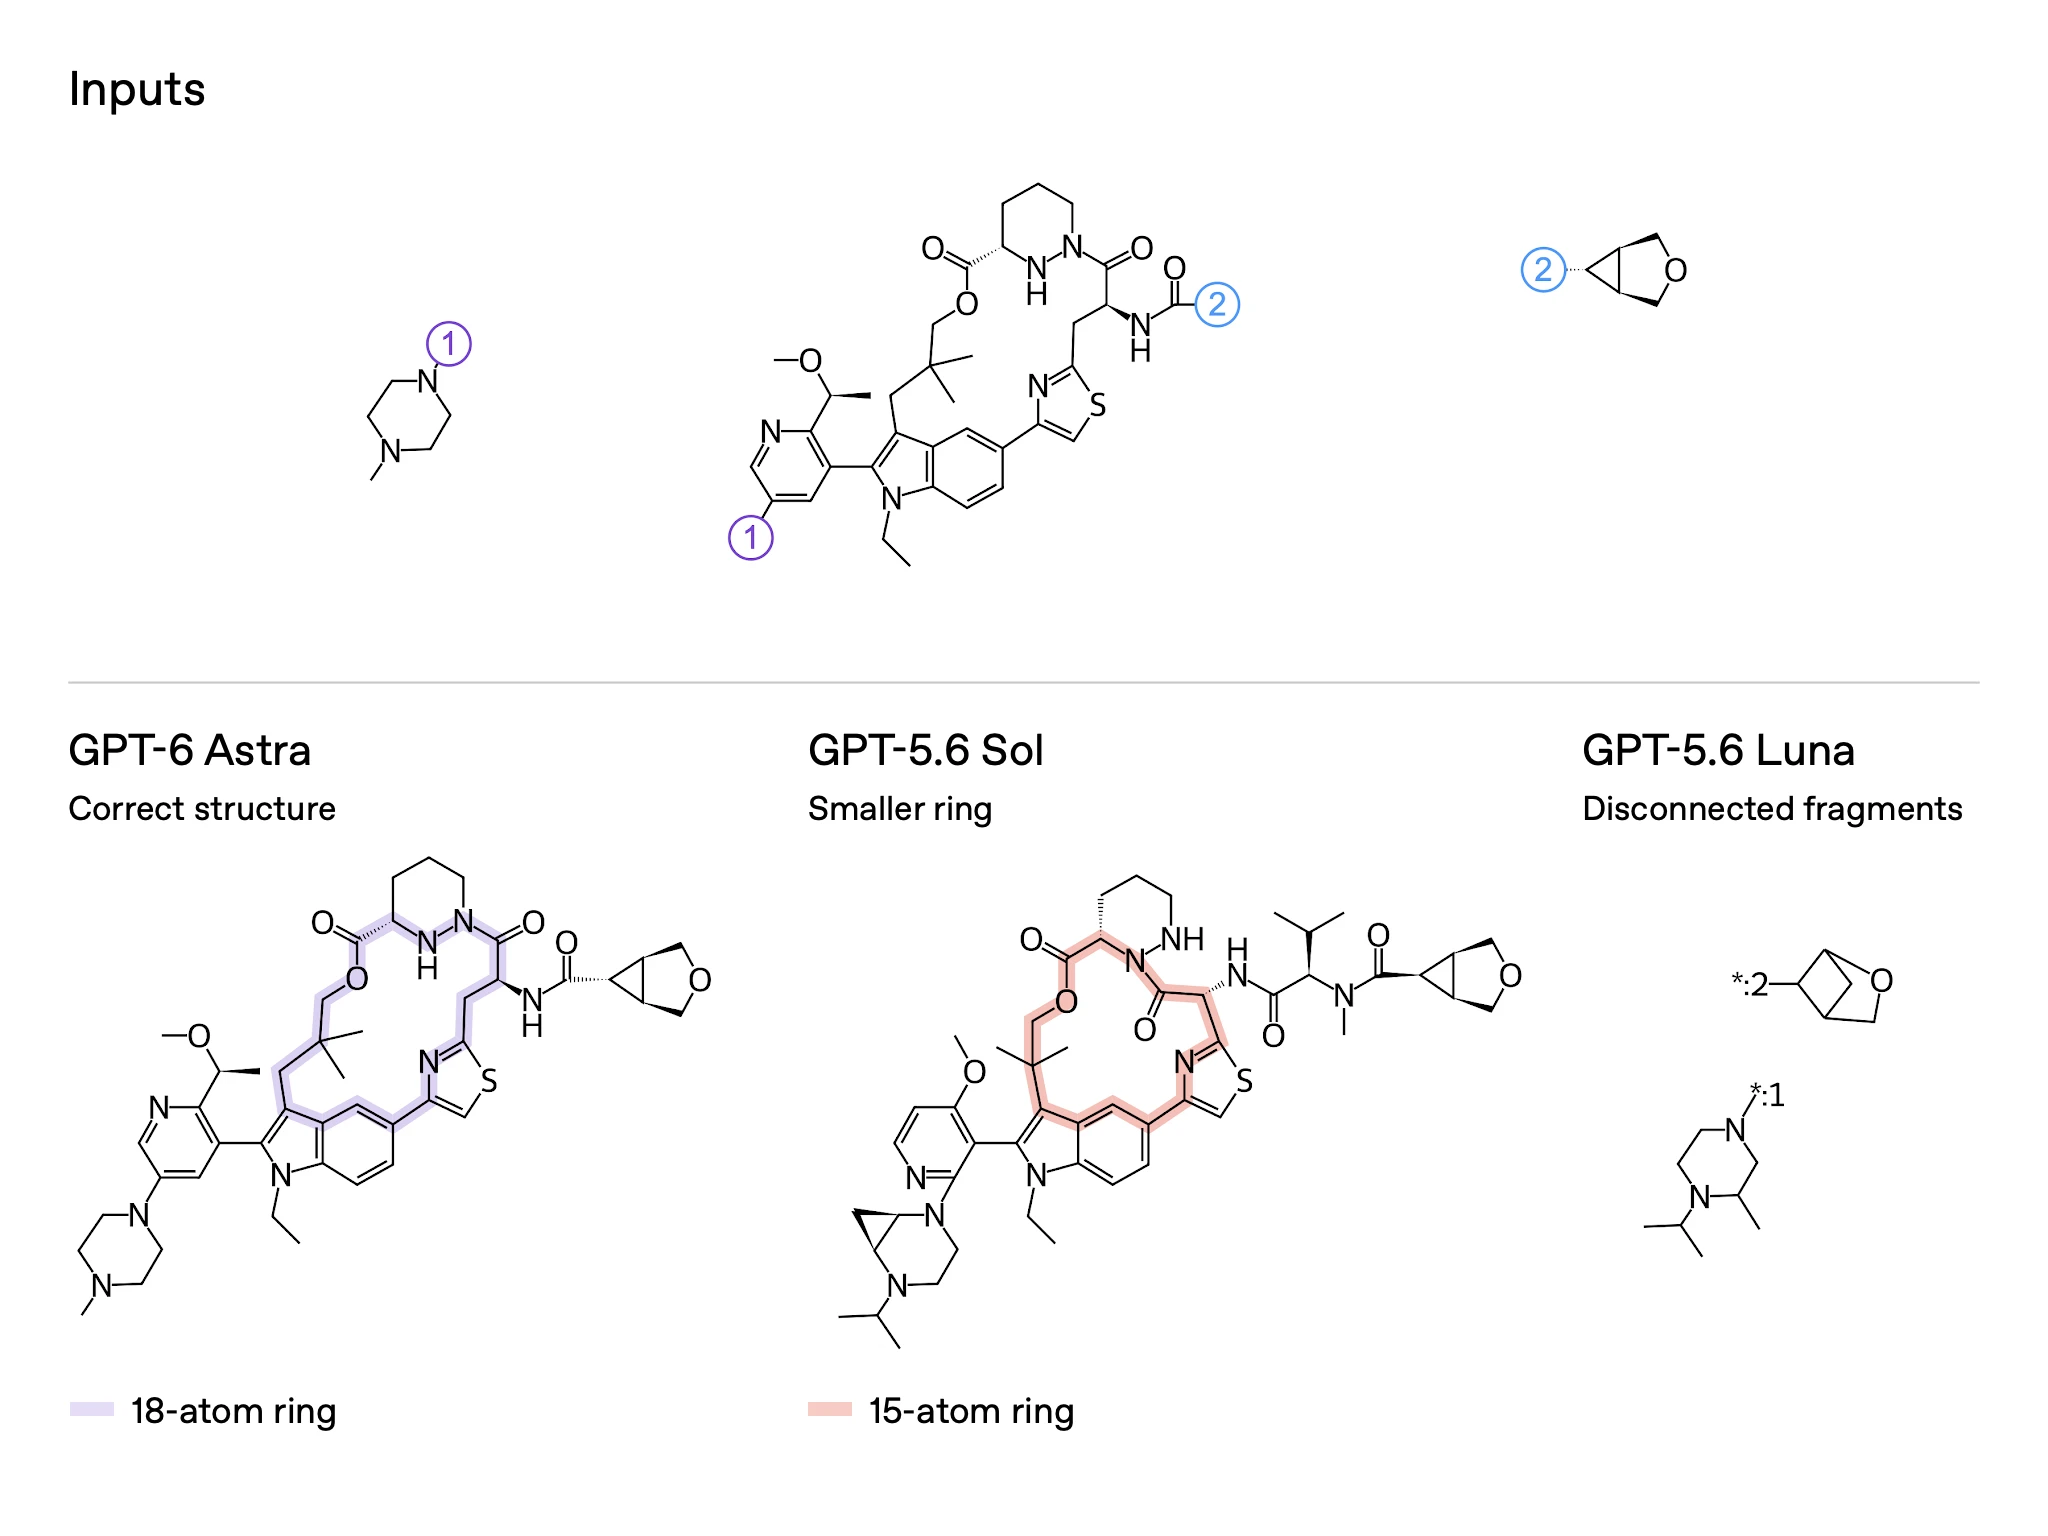
这些针对化合物17的选定答案显示了一个正确的分子重建、一个较小的环以及不连通的碎片。
在衡量结构组件基准时,Astra在xhigh设置下获得了95.4%的可用积分。这一结果表明其在重建任务中提供的分子结构方面表现出色。
我们评估了十一个具有不同推理努力设置的GPT模型。在整个基准测试中,Astra在共享的xhigh设置下获得了83.3%的可用积分,相比之下,GPT‑6.1 Sol为82.0%,GPT‑6.1 Terra为75.1%,GPT‑5.6 Sol为58.2%。在最大努力设置下,GPT‑6 Astra达到了83.8%。更高的推理设置提高了得分,同时模型之间仍然存在巨大差异。下图绘制了性能与输出令牌的关系。
图2。性能与令牌使用量的对比
每个点代表一个模型在某个推理设置下的表现,展示了自GPT‑5.6以来九个模型的51种组合。得分是对99个问题求平均值后的结果;条形图显示了95%的不确定性区间。令牌包括推理部分和最终答案。
组件结果区分了四种能力:重建分子、解释研究结果、选择化合物以及预测测量结果。这显示了模型的优势所在以及错误仍然存在的领域。
图3。组件性能与令牌使用量的对比
Astra最明显的优势在于重建分子结构和解释科学证据。在我们预印本中精选的推理示例中,Astra正确识别了结构变化,并权衡了它们对蛋白质结合、吸收和代谢可能产生的影响。
在选择和预测仍然困难的领域中,Astra在xhigh下获得了95.4%的可用结构积分,但关于选择化合物和预测数值属性的积分仅获得了一半左右。这些类别使用了不同的任务和评分规则,但结果表明在改进预测和化合物选择方面仍有很大的提升空间。
未来的发展方向
这些结果并未确立模型是否能够发现新药物或改进实验室决策。无法排除先前接触过已发表来源的可能性,并且每个响应都是在没有工具、反馈或新实验的情况下的单次尝试。虽然该基准测试评估的是基于历史证据的推理,而非现实世界中的药物发现,但其结果有助于识别模型正在取得进展的领域以及依然存在的挑战。我们相信MedChemBench将支持持续的进步,并期待随着我们的模型不断发展以服务于该领域而分享最新进展。
2026
作者
OpenAI
正文为 AI 译文。
参考来源




